L'avantage de l'IA que la puissance de calcul ne peut pas acheter
Présentation de Sensia Gen 8
Nous vous présentons aujourd’hui Sensia Gen 8, la nouvelle génération de notre moteur d’intelligence qualitative. Elle combine nos modèles spécialisés de huitième génération avec des avancées dans la manière dont le système prépare les données, sélectionne les éléments pertinents et utilise des fenêtres de contexte plus larges pour les modèles linguistiques. Ensemble, ces capacités transforment de grands volumes de retours d’expérience fragmentés en conclusions structurées que les équipes peuvent analyser, explorer et retracer jusqu’à leurs sources. Notre test de performance montre comment le moteur fonctionne : de petits échantillons bien choisis permettent d’identifier les produits à l’origine de la quasi-totalité des avis pertinents sur une question donnée, et les principaux résultats restent valables, qu’il s’agisse de quelques centaines d’avis ou de la fenêtre contextuelle complète du modèle de rédaction. À mesure que les capacités générales de l’IA se développent, cela montre où se construit un avantage durable.
Ce qu’apporte Sensia Gen 8
Gen 8 n’est pas un nouveau modèle linguistique, et il ne s’agit pas seulement d’un nouvel ensemble de nos propres modèles. Il s’agit d’une nouvelle génération de l’ensemble du moteur : les modèles spécialisés qui comprennent ce que les consommateurs écrivent, la mesure fondée sur cette compréhension, la préparation et la sélection des éléments pertinents pour chaque question, l’utilisation de fenêtres de contexte beaucoup plus larges, ainsi que les modèles polyvalents qui synthétisent et rédigent. Ce qui change, c’est ce que le moteur dans son ensemble est capable de faire.
Pourquoi est-ce important aujourd’hui ?
Le secteur de l’IA répond à la question des capacités par des investissements d’une ampleur historique. Selon le Morning Bid de Reuters, tel que rapporté par 24/7 Wall St. (Yahoo Finance), les dépenses combinées des plus grands fournisseurs de cloud pour 2026 ont dépassé les 700 milliards de dollars. Ces dépenses augmentent les capacités mises à la disposition de tous. La question qui reste en suspens est de savoir ce que cela rapportera, et où.
Il est utile de distinguer trois écosystèmes économiques. La première concerne l’infrastructure : les entreprises qui construisent des centres de données et louent de la puissance de calcul. La deuxième concerne les fournisseurs de modèles, qui transforment cette puissance de calcul en modèles polyvalents. La troisième concerne les entreprises qui développent ou achètent des applications s’appuyant sur ces modèles, et attendent d’elles qu’elles produisent des résultats. Chacune doit prouver sa propre rentabilité, et ces trois composantes n’évoluent pas au même rythme.
Pour la première, Gartner a formulé la question sous forme de comparaison en octobre. Pour couvrir leurs dépenses d’investissement annoncées, leurs coûts de financement et un rendement de 12 % sur le capital investi, les propriétaires de centres de données d’IA auraient besoin d’un chiffre d’affaires cumulé de 8 500 milliards de dollars d’ici 2030. Les revenus liés à l’IA que Gartner prévoit que les centres de données généreront sur cette période ne dépassent pas 3 600 milliards de dollars (Gartner).
Cet écart ne signifie pas que l’IA va échouer. Il indique simplement que la valeur devra provenir des utilisations, et que ces utilisations n’ont pas encore fait leurs preuves à l’échelle de l’investissement. L’infrastructure est financée avant même que les applications censées la rentabiliser ne soient en place.
Le rythme de renouvellement accentue ce constat. Une analyse soutient que les puces d’IA de pointe conservent leur avantage économique pendant un à trois ans, contre les cinq ou six ans pris en compte dans les comptes des entreprises ; son auteur la présente comme un travail en cours (CITP de Princeton). Les données du marché indiquent une tendance inverse pour le matériel plus ancien : en septembre, Ornn a signalé que les anciennes générations de GPU conservaient une durée de vie rentable de plusieurs années en matière d’inférence, le taux d’utilisation des A100 chez les fournisseurs suivis passant de 74 % à 90 % entre mars et septembre 2026 (Ornn). Perdre son statut de « pointe de la technologie » ne signifie pas pour autant devenir inutilisable. Ces deux observations aboutissent à la même conclusion pratique : adapter le niveau de capacité approprié à chaque tâche devient une compétence économique à part entière.
Lorsque l’IA est intégrée au travail concret, sa valeur est tangible. Microsoft indique qu’Azure a enregistré une croissance de 41 % et a dépassé pour la première fois les 100 milliards de dollars de chiffre d’affaires, tandis que sa marge brute sur le cloud est tombée à 66 %, en raison d’investissements continus dans l’infrastructure d’IA (rapport annuel 2026 de Microsoft). Azure est une activité cloud à part entière, et non une simple source de revenus issue de l’IA, mais la direction à suivre est claire. Lorsque l’IA n’est pas intégrée au travail, la valeur est plus difficile à cerner : l’étude du MIT de 2025 sur les programmes d’entreprise a révélé que la plupart des projets pilotes d’IA générative s’étaient enlisés avant une adoption à grande échelle, et a attribué cet écart principalement à l’intégration dans les flux de travail réels plutôt qu’à la qualité des modèles (Computing).
Pour une entreprise qui met en œuvre l’IA, la question n’est donc pas de savoir à quelles capacités elle peut accéder. Il s’agit plutôt de déterminer quelles capacités créent une valeur durable dans son application, et lesquelles elle doit adopter auprès de fournisseurs qui ne cessent de les améliorer.
Lire davantage ne signifie pas apprendre davantage
Prenons l’application sur laquelle travaille Sensia : comprendre ce que les consommateurs écrivent sur les produits d’une catégorie donnée, à l’échelle de l’ensemble d’un marché. Un seul ensemble de données peut contenir des centaines de milliers d’avis, portant sur de nombreux produits, rédigés en plusieurs langues et utilisant un vocabulaire qui lui est propre. Une grande partie de ces avis se répète. Une grande partie ne répond pas à la question posée.
La réponse intuitive consiste à fournir à un modèle puissant autant de données que possible. Mais cela n’est pas évolutif : un portefeuille complet est plusieurs fois plus volumineux que la plus grande fenêtre contextuelle. Des recherches menées par Chroma ont mis en évidence une utilisation inégale des contextes longs et une fiabilité décroissante à mesure que le volume des données d’entrée augmentait dans les modèles et les tâches testés (Chroma). Il s’agit également d’un objectif erroné. Lire davantage de texte et rédiger un rapport plus long à partir de celui-ci ne signifie pas automatiquement en apprendre davantage.
Ce qui importe, c’est que le contenu lu par le modèle comporte des informations pertinentes pour la question posée et touche la partie du marché où les consommateurs en parlent réellement. Cela nécessite de comprendre chaque citation mot pour mot avant toute rédaction, puis de préparer les éléments probants adaptés à chaque question. C’est précisément pour ce travail que Gen 8 a été conçu.
Comment fonctionne Gen 8
Gen 8 combine deux types de capacités. La première est la nôtre. Nous entraînons une vingtaine de modèles verticaux propriétaires, désormais dans leur huitième génération, chacun spécialisé dans le langage d’une catégorie, des soins de la peau à l’alimentation pour animaux de compagnie. Ils évaluent chaque transcription, et la mesure ainsi que la sélection des éléments probants s’appuient sur cette évaluation. Nous n’entraînons pas de grands modèles linguistiques ; nous entraînons des modèles qui comprennent les marchés.
Les modèles linguistiques à usage général apportent des capacités de synthèse, de raisonnement et de rédaction qui ne cessent de s’améliorer. Gen 8 applique ces capacités aux éléments probants déjà préparés pour la question.
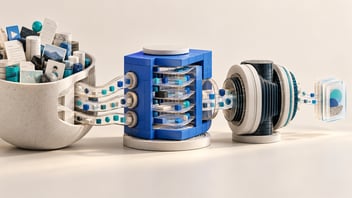
Le moteur Sensia Gen 8. La manière dont les transcriptions sont validées, ainsi que la sélection et l’assemblage des éléments probants, restent des informations confidentielles.
Pourquoi les fenêtres de contexte plus larges sont importantes
Le modèle de rédaction utilisé dans Gen 8 peut être configuré pour lire environ un million de tokens en un seul appel, soit plusieurs milliers d’avis à la fois. Pour un moteur comme Gen 8, cela élargit le champ des possibilités : la même analyse peut s’appliquer à un échantillon ciblé ou à plusieurs milliers d’avis par section, et la profondeur devient un paramètre choisi pour chaque question plutôt qu’une limite stricte.
Une fenêtre plus large ne garantit pas automatiquement un meilleur résultat. Chaque volume supplémentaire de données entraîne une consommation de ressources du modèle linguistique et rallonge le délaii de génération, et cela n’a d’importance que si cela améliore un aspect qui importe à l’équipe : la portée des preuves, leur profondeur, la stabilité des résultats. Savoir ce qu’apporte chaque volume supplémentaire, c’est ce qui transforme une fenêtre plus large en une capacité exploitable. C’est ce que nous avons cherché à mesurer.
Mise à l’épreuve de la génération 8
Nous avons testé le moteur là où il est le plus mis à rude épreuve. Nous avons pris cinq analyses réelles issues de trois des portefeuilles les plus vastes et les plus variés de notre production, dans les domaines des soins de la peau et de l’alimentation pour animaux de compagnie, et nous les avons régénérées avec six volumes de données différents : des échantillons utilisés jusqu’à présent dans nos analyses, soit quelques centaines d’avis par section, jusqu’à la fenêtre contextuelle maximale du même modèle d’écriture, qui atteignait environ 9 000 avis par section. Même cela ne correspond pas à la lecture d’un portefeuille complet. Sur deux sections critiques, nous avons également comparé notre configuration à une référence de raisonnement à plus large contexte. Nous avons ensuite posé trois questions.
Une sélection restreinte permet-elle de cerner l’essentiel ?
La sélection d’un échantillon limité n’est utile que si elle couvre les produits pour lesquels les consommateurs abordent réellement la question. Pour vérifier cela, nous avons reconstitué, pour quatre questions, l’ensemble complet des avis pertinents de chaque portefeuille, puis mesuré la part de cet ensemble associée aux produits présents dans chaque échantillon. Il s’agit d’une mesure de la couverture de l’échantillon par rapport aux données sources. Ce n’est pas un pourcentage d’informations extraites.
Pour ces quatre questions, des échantillons d’environ 1 500 avis comprenaient des produits représentant entre 98,1 % et 99,5 % du volume d’avis pertinents.
La portée dépend de la question. Avec environ 1 000 avis, elle se situait déjà entre 94 % et 99 % ; l'évolution variait selon les questions, l'une d'entre elles atteignant 94,4 % avec environ 1 000 avis et 98,1 % avec environ 1 500. La profondeur est donc un paramètre adapté à chaque question, et non une règle fixe.
Ces résultats restent-ils valables à mesure que la profondeur augmente ?
Sur cinq analyses de production, les principaux résultats stratégiques sont restés cohérents pour les six configurations de profondeur, allant de quelques centaines d’avis par section jusqu’à la fenêtre de contexte maximale du modèle de rédaction, atteignant environ 9 000 avis. Les principaux domaines d’opportunité, le principal facteur de choix et les compromis centraux sont restés cohérents dans les analyses où ils ont été évalués.
Une plus grande profondeur a permis d’étoffer les éléments disponibles à l’appui de cette analyse. Elle pourrait apporter des références supplémentaires sur les produits, des détails complémentaires ou des citations plus longues de consommateurs, sans modifier les principales conclusions stratégiques. Pour la Génération 8, cela fait de la profondeur une capacité utile pour s’adapter à la question : une équipe peut approfondir ses recherches là où elle a besoin de plus d’éléments, tout en conservant une analyse cohérente du marché.
Sur ces mêmes vingt sections, la configuration à fenêtre maximale a utilisé environ treize fois plus de ressources LLM que la configuration à environ 1 000 avis. L’analyse comparative permet donc de distinguer les éléments de preuve supplémentaires d’une modification des principales conclusions, et d’évaluer l’apport de cette profondeur supplémentaire.
Un modèle plus puissant apporte-t-il davantage de décisions ?
Sur deux sections critiques, une référence de raisonnement à plus grande échelle a analysé environ deux fois plus de données, déjà préparées par Sensia, que notre configuration de production.
Les deux configurations ont produit des conclusions principales comparables dans les deux sections examinées. La configuration de référence « raisonnement » a apporté quelques nuances dans la formulation ; aucune nouvelle décision majeure n’a été observée. Sa consommation de LLM était plus de trente fois supérieure. Nous décrivons ce que ces résultats signifient pour les équipes chargées de la marque dans un article complémentaire, et pour les responsables de l’IA et des données dans un autre.
Ce que cela révèle sur la source de la valeur
Ce résultat ne porte pas principalement sur les coûts. Il corrobore l’idée selon laquelle la qualité d’un système d’IA appliqué peut découler d’une capacité qui précède le modèle : celle de comprendre suffisamment bien les données d’un domaine pour sélectionner les informations pertinentes et les transmettre au modèle. Cette capacité est un atout. Elle se construit catégorie par catégorie, s’améliore à chaque génération de nos propres modèles et n’est pas fournie avec la sortie du prochain modèle.
Cela modifie également notre rapport aux progrès des modèles polyvalents. Comme la compréhension des données réside dans les modèles que nous possédons, le modèle linguistique occupe un rôle bien défini au sein du moteur. Lorsqu’un modèle plus performant fait son apparition, nous pouvons l’adopter sans avoir à reconstruire notre compréhension de chaque marché, en vérifiant au préalable les résultats, et ses avantages profitent à nos clients. Le passage de GPT-5.4 à Luna illustre cette flexibilité ; le benchmark examine séparément le comportement du système actuel avec différentes tailles d’échantillons et avec un modèle de raisonnement plus performant. Notre dépendance vis-à-vis des modèles à usage général ne disparaît pas ; elle devient un choix que nous pouvons gérer.
C’est là la différence entre deux approches. L’une repousse les limites des capacités des modèles, et l’ensemble du secteur en bénéficie. L’autre porte sur les performances dans une application donnée : identifier les capacités qui y génèrent de la valeur, investir dans celles qui font la différence, et adopter le reste auprès de ceux qui sont les mieux placés pour les améliorer. Gen 8 est notre réponse à cette seconde approche.
Un avantage qui se renforce
Les milliards investis dans les modèles et les infrastructures continueront d’accroître les capacités mises à la disposition de tous. C’est une bonne nouvelle pour toutes les entreprises qui utilisent l’IA, y compris la nôtre. Cela signifie également que les capacités générales, à elles seules, ne permettront à personne de se démarquer.
« Les modèles ne cesseront de s’améliorer, et nous voulons que nos clients tirent profit de chaque avancée. Ce dans quoi nous investissons, c’est ce qui ne vient pas avec le prochain modèle : la compréhension de chaque marché et les données factuelles qui sous-tendent chaque conclusion. »
Antoine Poupel, PDG de Sensia
C’est là l’avantage que la puissance de calcul ne peut pas acheter.
- Pour les équipes chargées de la marque et des analyses : quatre exigences à poser aux analyses de consommation basées sur l’IA
- Pour les responsables de l’IA et de la transformation : Développer l’IA à partir des données clients : plus de données, un modèle plus performant ou un meilleur signal ?
À propos des tests : cinq analyses de production (vingt sections) sur trois portefeuilles de référence dans les domaines des soins de la peau et de l’alimentation pour animaux de compagnie, régénérées avec six quantités de données allant jusqu’à la fenêtre de contexte maximale du modèle de rédaction, plus une référence de raisonnement à plus large contexte sur deux sections : 122 générations, octobre 2026. Portée mesurée sur quatre questions. Principales conclusions comparées par une lecture côte à côte. Le benchmark évalue le moteur Gen 8 dans plusieurs configurations ; il ne s’agit pas d’une comparaison contrôlée avec la génération précédente. Coût du LLM calculé selon la grille tarifaire publique du fournisseur, et non le coût total de la plateforme Sensia.